
Escalabilidade e elasticidade
O que são failover e redundância em SaaS?
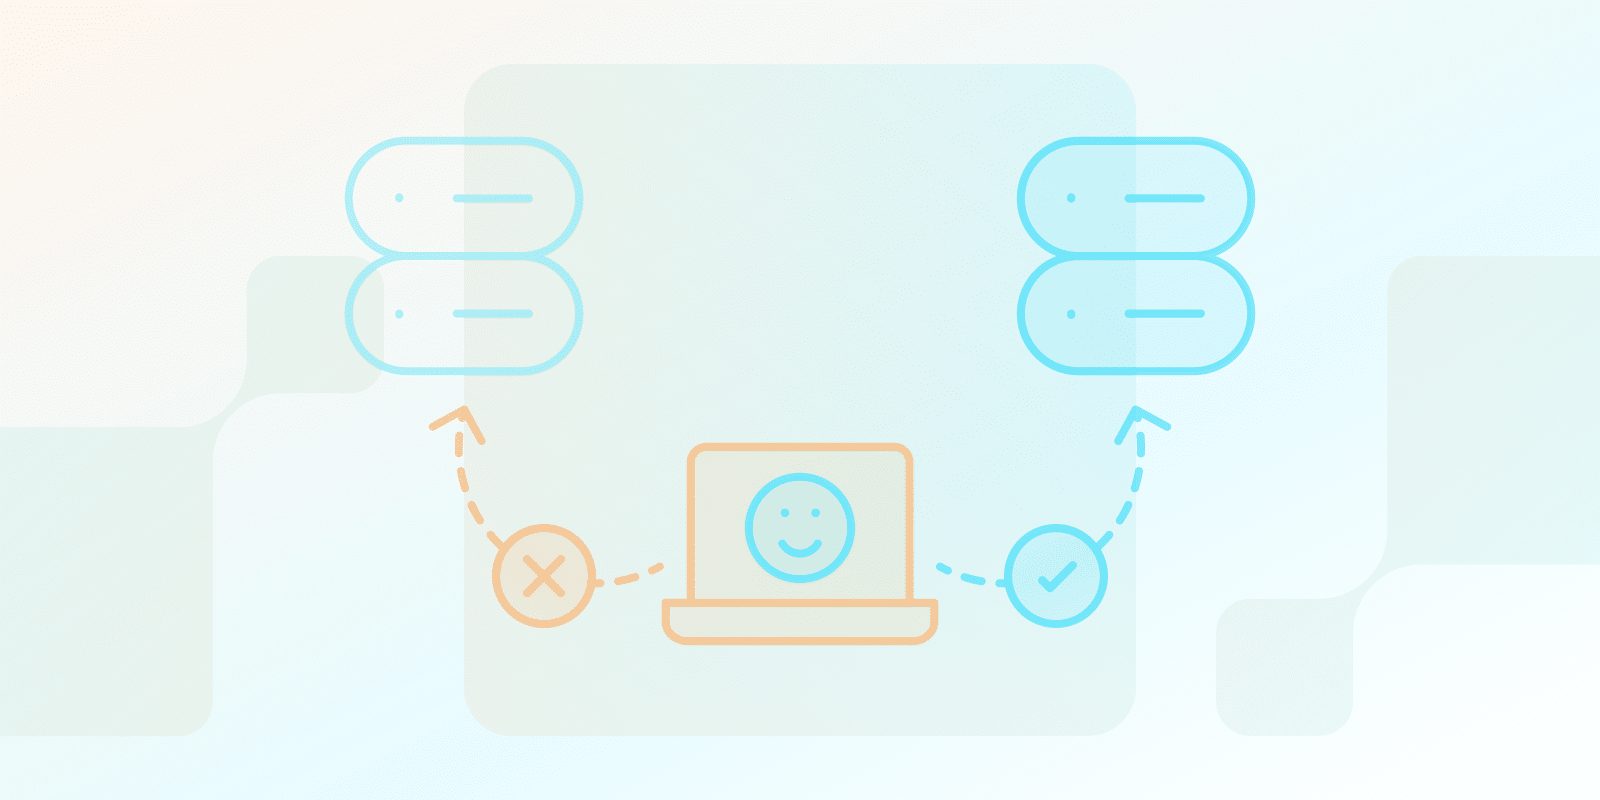
O que são failover e redundância?
Failover e redundância são métodos usados para manter a funcionalidade dos seus sistemas, mesmo durante falhas inesperadas. A redundância envolve ter peças ou sistemas de backup como substitutos, enquanto o failover é a alternância, geralmente automática, para esses backups quando o sistema original falha. O Amazon RDS, por exemplo, alterna uma instância de banco de dados Multi-AZ para sua réplica em espera; os tempos de failover são normalmente de 60 a 120 segundos.
Por si só, o failover resolve problemas menores ou localizados, que geralmente têm escopo limitado, enquanto a recuperação de desastres (DR) é uma solução para problemas extensos, como desastres naturais, ameaças cibernéticas ou falhas no sistema.
A presença de configurações de redundância e failover geralmente se relaciona com o nível de interrupção sofrido durante a manutenção e atualizações, impactando a continuidade do serviço. Isso é crucial nos negócios, onde mesmo pequenas interrupções podem custar caro.
Redundância é como ter um pneu sobressalente para o seu carro. Não é essencial para dirigir, mas é crucial se você furar um pneu.
Qual é a diferença entre redundância e alta disponibilidade?
Redundância é uma técnica usada especificamente para atingir alta disponibilidade. Considere a redundância como um instrumento na caixa de ferramentas. Envolve ter um backup de um ou mais equipamentos para garantir contingência no caso de o inicial falhar.
A alta disponibilidade (HA), por outro lado, é a estratégia geral de garantir que seus sistemas estejam operacionalmente confiáveis com o mínimo de interrupção. Ela inclui uma gama mais ampla de estratégias, não apenas redundância, mas também:
- Balanceamento de Carga: Dividir cargas entre vários servidores para evitar que uma tarefa sobrecarregue alguns dos servidores.
- Manutenção Regular: Antecipar e corrigir problemas antes que ocorram falhas e comprometam o fluxo de trabalho em uma organização empresarial.
- Monitoramento Robusto: Identificar rapidamente falhas e executar o failover necessário ou outros processos de recuperação.
Além disso, para garantir alta disponibilidade em ambientes dinâmicos, os sistemas precisam incorporar Escalabilidade e elasticidade para se adaptar a cargas de trabalho em constante mudança.
Portanto, a redundância não é o único fator de alta disponibilidade, mas um componente importante.
| Aspecto | Redundância | Alta Disponibilidade |
|---|---|---|
| Definição Principal | ||
| Definição | Uma técnica para garantir o backup e a contingência do sistema | Estratégia abrangente para manter a confiabilidade do sistema |
| Objetivo Principal | Fornecer sistemas de backup para evitar tempo de inatividade | Garantir a interrupção mínima do sistema |
| Abordagem Operacional | ||
| Estratégias Principais | Equipamentos e sistemas de backup | Balanceamento de carga, manutenção, monitoramento, escalabilidade |
| Escopo | Limitado, focado em sistemas de backup | Amplo, abrangendo múltiplas técnicas de confiabilidade do sistema |
| Implementação | ||
| complexidade | Mecanismo de backup relativamente simples | Abordagem mais complexa e multifacetada |
| Relacionamento | Um componente de alta disponibilidade | Inclui redundância como estratégia |
Quais são os três tipos de redundância?
Três tipos comuns de redundância são:
- Ativo-Ativo: Ambos os sistemas redundantes compartilham simultaneamente a carga de trabalho para utilização máxima de recursos.
- Ativo-Passivo: Um sistema está totalmente operacional (ativo), e o outro sistema não está (passivo) e só entra em operação quando o sistema ativo falha.
- Redundância N+1: Você tem o número de sistemas necessários para operações normais (N), mais um sistema para fins de backup.
Esses modelos podem ser aplicados em várias camadas: energia (unidades de UPS e geradores), links de rede de diferentes provedores, armazenamento como RAID e servidores. Uma rede redundante mantém um segundo caminho pronto se um link falhar.
Seu SaaS precisa de failover e redundância?
Decidir se você precisa de failover e redundância depende de vários fatores. Considere as seguintes questões:
- Sua empresa pode lidar com qualquer inatividade?
- Quão essenciais são seus serviços para seus clientes?
- Quais são os impactos financeiros das interrupções de serviço?
Se a inatividade se traduz em perda de vendas ou erosão da confiança do cliente, ou quebra o tempo de atividade prometido em seu Tenha seu, então a redundância e o failover podem provar ser soluções econômicas.
Serviços gerenciados podem executar failover para partes de sua infraestrutura: no Amazon RDS, os tempos de failover para uma instância de banco de dados Multi-AZ são normalmente de 60 a 120 segundos (AWS). Teste antes de precisar; o RDS permite forçar um failover reiniciando a instância.
Qual é a diferença entre redundância e recuperação de desastres?
Redundância e recuperação de desastres (DR) contribuem para manter seus sistemas operacionais, mas abordam cenários diferentes:
Redundância:
- Foco: Minimizar as chances de sofrer inatividade em primeiro lugar.
- Como funciona: Usa peças de reposição ou um sistema extra similar para assumir quando o principal para de funcionar.
- Quando é usada: Para problemas menores, como falha de hardware ou falha de energia em nível de nó/instalação único.
- Pense nisso como: Um pneu reserva de carro mantido como backup para o caso de você furar um pneu.
Recuperação de Desastres:
- Foco: Restaurar sistemas e dados após um grande evento de interrupção.
- Como funciona: Envolve um plano abrangente para fazer backup de dados, mover operações para um site secundário e restaurar sistemas online.
- Quando é usada: Em casos de grandes eventos como desastres naturais, ameaças cibernéticas ou mesmo situações em que todo o sistema trava.
- Pense nisso como: Semelhante às apólices de seguro empresarial, é usado para facilitar a recuperação em caso de desastre.
Em resumo, a redundância é usada para evitar inatividades inesperadas, e a recuperação de desastres é usada para restaurar sistemas e dados após uma grande interrupção. A redundância difere de um backup, pois problemas como exclusão ou criptografia de dados podem ser replicados para sistemas em espera, indicando que estratégias de backup distintas são relevantes para recuperação de desastres.
Conclusão
Redundância e failover são alguns dos conceitos mais vitais que se pode usar para fornecer confiabilidade e disponibilidade de sistemas críticos. Compreenda e implemente estrategicamente esses conceitos para lidar com interrupções inesperadas e gerenciar as operações de maneira eficaz.
Pronto para começar?


 Português do Brasil
 English
 Español
 Português
 Français
 Italiano
 Deutsch
 Nederlands
 Polski
 Română
 Українська
 简体中文
 日本語
 한국어