
évolutivité et élasticité
Qu'est-ce que le basculement et la redondance dans le SaaS ?
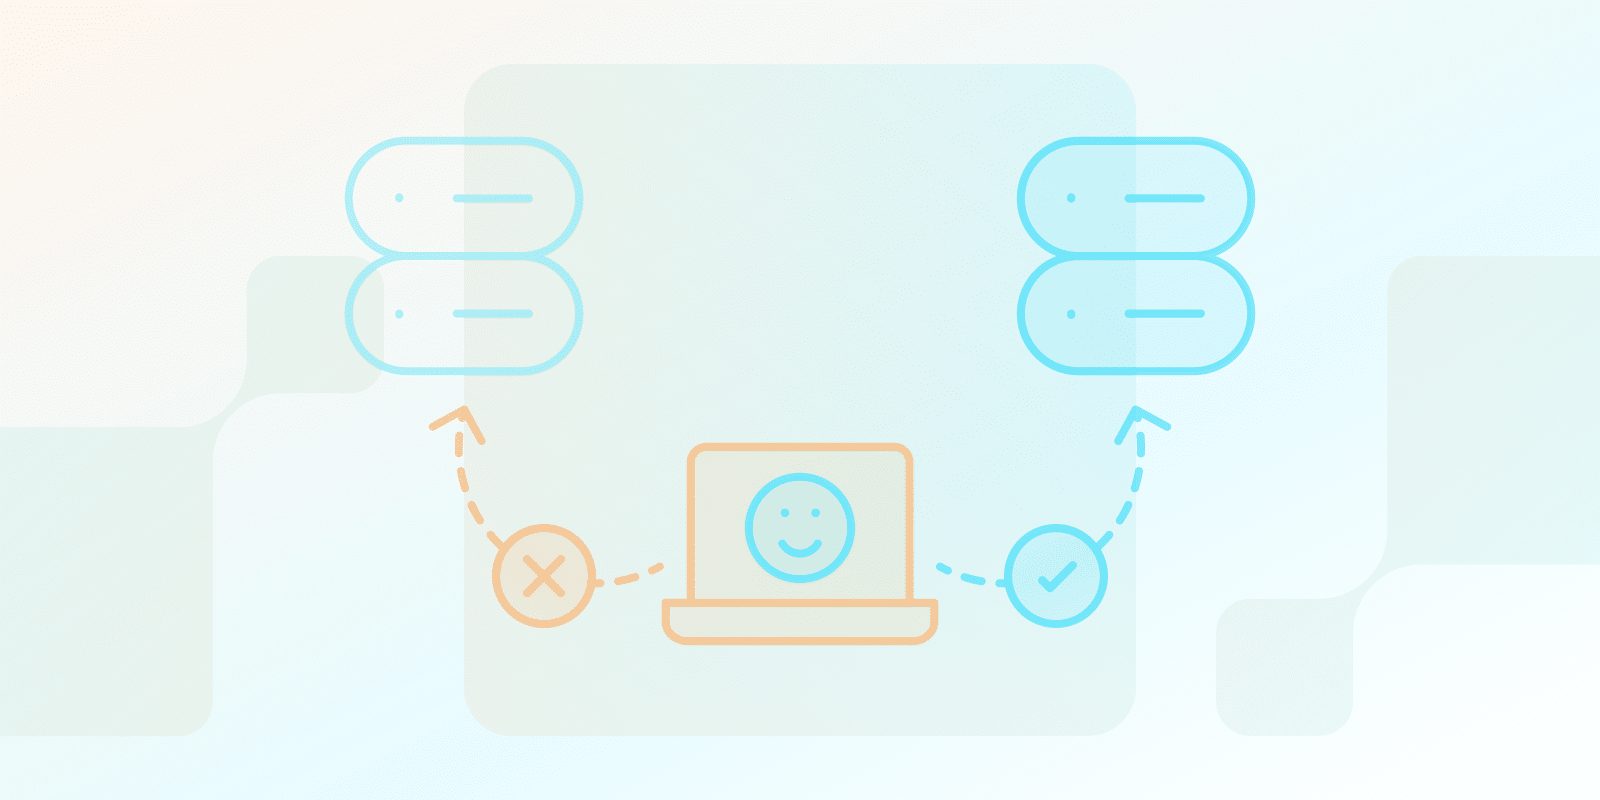
Qu'est-ce que le basculement et la redondance ?
Le basculement et la redondance sont des méthodes utilisées pour maintenir la fonctionnalité de vos systèmes, même lors de pannes imprévues. La redondance consiste à disposer de pièces ou de systèmes de secours comme substituts, tandis que le basculement est le passage, généralement automatique, à ces sauvegardes lorsque le système d'origine tombe en panne. Amazon RDS, par exemple, bascule une instance de base de données Multi-AZ vers sa réplique de secours ; les temps de basculement sont généralement de 60 à 120 secondes.
À lui seul, le basculement résout des problèmes mineurs ou localisés, dont la portée est généralement limitée, tandis que la reprise après sinistre (DR) est une solution pour des problèmes de grande envergure tels que les catastrophes naturelles, les cybermenaces ou les pannes de système.
La présence de configurations de redondance et de basculement est souvent liée au niveau de perturbation subi lors de la maintenance et des mises à niveau, ce qui a un impact sur la continuité du service. C'est un aspect crucial dans les affaires, où même des perturbations mineures peuvent s'avérer coûteuses.
La redondance, c'est comme avoir une roue de secours pour votre voiture. Ce n'est pas essentiel pour conduire, mais crucial en cas de crevaison.
Quelle est la différence entre la redondance et la haute disponibilité ?
La redondance est une technique utilisée spécifiquement pour atteindre une haute disponibilité. Considérez la redondance comme un instrument dans la boîte à outils. Cela implique d'avoir une sauvegarde d'un ou plusieurs équipements pour assurer une éventualité en cas de défaillance de l'équipement initial.
La haute disponibilité (HA), quant à elle, est la globale stratégie visant à garantir que vos systèmes sont opérationnels de manière fiable avec un minimum d'interruption. Elle englobe un éventail plus large de stratégies, et pas seulement la redondance, notamment :
- Équilibrage de charge : Répartition des charges entre différents serveurs pour éviter qu'une tâche ne surcharge certains serveurs.
- Maintenance régulière : Anticipation et résolution des problèmes avant qu'ils ne surviennent et ne compromettent le flux de travail dans une organisation commerciale.
- Surveillance robuste : Identifier rapidement les pannes et exécuter le basculement nécessaire ou d'autres processus de récupération.
En outre, pour garantir une haute disponibilité dans des environnements dynamiques, les systèmes doivent intégrer évolutivité et élasticité pour s'adapter aux charges de travail changeantes.
Par conséquent, la redondance n'est pas le seul facteur de haute disponibilité, mais un composant important.
| Aspect | Redondance | Haute disponibilité |
|---|---|---|
| Définition principale | ||
| Définition | Une technique pour assurer la sauvegarde et la contingence du système | Stratégie complète pour maintenir la fiabilité du système |
| Objectif principal | Fournir des systèmes de sauvegarde pour éviter les temps d'arrêt | Garantir une interruption minimale du système |
| Approche opérationnelle | ||
| Stratégies clés | Équipements et systèmes de sauvegarde | Équilibrage de charge, maintenance, surveillance, évolutivité |
| Portée | Restreint, centré sur les systèmes de sauvegarde | Large, englobant plusieurs techniques de fiabilité du système |
| Mise en œuvre | ||
| complexité | Mécanisme de sauvegarde relativement simple | Approche plus complexe et multiforme |
| Relation | Une composante de la haute disponibilité | Inclut la redondance comme stratégie |
Quels sont les trois types de redondance ?
Trois types courants de redondance sont:
- Actif-Actif : Les deux systèmes redondants partagent simultanément la charge de travail pour une utilisation maximale des ressources.
- Actif-Passif : Un système est entièrement opérationnel (actif), et l'autre système ne l'est pas (passif) et n'entre en fonctionnement que lorsque le système actif tombe en panne.
- Redondance N+1 : Vous disposez du nombre de systèmes requis pour les opérations normales (N), plus un système supplémentaire à des fins de sauvegarde.
Ces modèles peuvent s'appliquer à plusieurs niveaux : l'alimentation (onduleurs et générateurs), les liaisons réseau de différents fournisseurs, le stockage tel que le RAID, et les serveurs. Un réseau redondant maintient un second chemin prêt si une liaison tombe en panne.
Votre SaaS a-t-il besoin d'un basculement et d'une redondance ?
La décision de savoir si vous avez besoin d'un basculement et d'une redondance dépend de plusieurs facteurs. Tenez compte des questions suivantes :
- Votre entreprise peut-elle tolérer des temps d'arrêt?
- Dans quelle mesure vos services sont-ils essentiels pour vos clients ?
- Quels sont les impacts financiers des interruptions de service ?
Si les temps d'arrêt se traduisent par des pertes de ventes ou une érosion de la confiance des clients, ou s'ils rompent le taux de disponibilité promis dans votre accord de niveau de service, alors la redondance et le basculement peuvent s'avérer des solutions rentables.
Les services gérés peuvent assurer le basculement de parties de votre infrastructure : sur Amazon RDS, les temps de basculement pour une instance de base de données Multi-AZ sont généralement de 60 à 120 secondes (AWS). Testez-le avant d'en avoir besoin ; RDS vous permet de forcer un basculement en redémarrant l'instance.
Quelle est la différence entre la redondance et la reprise après sinistre ?
La redondance et la reprise après sinistre (DR) contribuent toutes deux à maintenir vos systèmes opérationnels, mais elles s'attaquent à des scénarios différents :
Redondance :
- Objectif : Minimiser les risques de subir un temps d'arrêt en premier lieu.
- Fonctionnement : Utilise des pièces de rechange ou un système similaire supplémentaire pour prendre le relais lorsque le système principal cesse de fonctionner.
- Quand il est utilisé : Pour des problèmes mineurs tels qu'une défaillance matérielle ou une panne de courant au niveau d'un seul nœud/installation.
- Pensez-y comme : Une roue de secours de voiture conservée en tant que sauvegarde au cas où vous auriez une crevaison.
Reprise après sinistre :
- Objectif : Restaurer les systèmes et les données après un incident perturbateur majeur.
- Fonctionnement : Implique un plan complet pour la sauvegarde des données, le déplacement des opérations vers un site secondaire et la restauration des systèmes en ligne.
- Quand il est utilisé : En cas d'événements majeurs tels que des catastrophes naturelles, des cybermenaces ou même des situations où l'ensemble du système tombe en panne.
- Pensez-y comme : Semblable aux polices d'assurance commerciale, il est utilisé pour faciliter la reprise en cas de sinistre.
En bref, la redondance est utilisée pour prévenir les temps d'arrêt imprévus, et la reprise après sinistre est utilisée pour restaurer les systèmes et les données après une perturbation majeure. La redondance diffère d'une sauvegarde, car des problèmes tels que la suppression ou le chiffrement de données peuvent être répliqués sur les systèmes de secours, ce qui indique que des stratégies de sauvegarde distinctes sont pertinentes pour Reprise après sinistre.
Conclusion
La redondance et le basculement sont parmi les concepts les plus essentiels que l'on puisse utiliser pour assurer la fiabilité et la disponibilité de systèmes critiques. Comprenez et mettez en œuvre stratégiquement ces concepts pour faire face aux perturbations imprévues et gérer efficacement les opérations.
Prêt à commencer ?


 Français
 English
 Español
 Português
 Português do Brasil
 Italiano
 Deutsch
 Nederlands
 Polski
 Română
 Українська
 简体中文
 日本語
 한국어