
schaalbaarheid en elasticiteit
Wat zijn failover en redundantie in SaaS?
Wat zijn failover en redundantie?
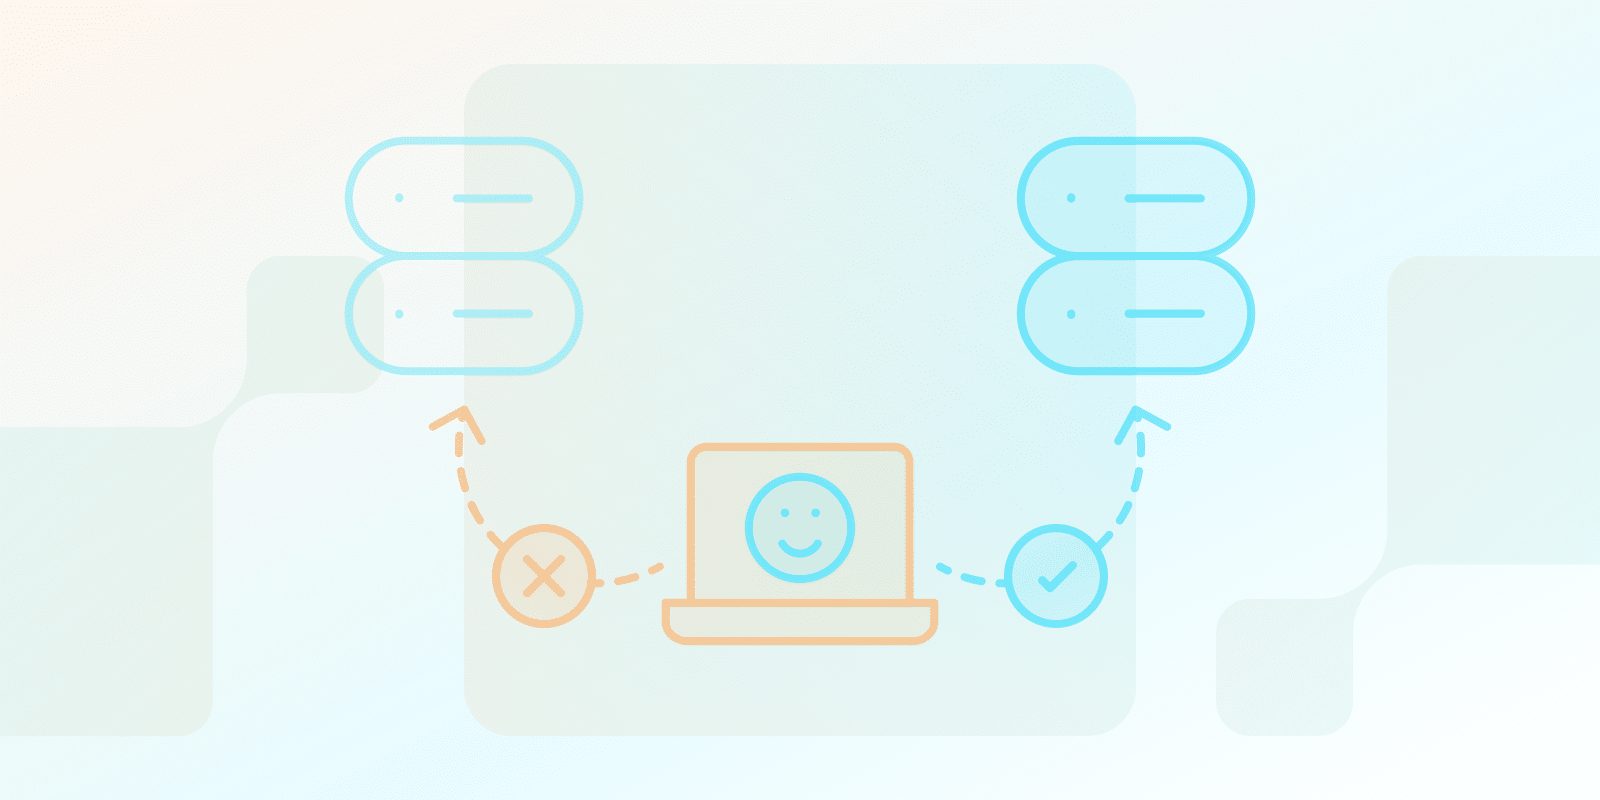
Failover en redundantie zijn methoden die worden gebruikt om de functionaliteit van uw systemen te behouden, zelfs tijdens onverwachte storingen. Redundantie houdt in dat er reserveonderdelen of -systemen als vervanging aanwezig zijn, terwijl failover de overschakeling is, meestal automatisch, naar die back-ups wanneer het oorspronkelijke systeem uitvalt. Amazon RDS schakelt bijvoorbeeld een Multi-AZ DB-instantie over naar de stand-by replica; de failover-tijden bedragen doorgaans 60-120 seconden.
Op zichzelf lost failover kleinere of lokale problemen op, die meestal beperkt van omvang zijn, terwijl disaster recovery (DR) een oplossing is voor omvangrijke problemen zoals natuurrampen, cyberdreigingen of systeemcrashes.
De aanwezigheid van redundantie- en failover-configuraties houdt vaak verband met de mate van onderbreking die wordt ervaren tijdens onderhoud en upgrades, wat invloed heeft op de continuïteit van de dienstverlening. Dit is cruciaal in het bedrijfsleven, waar zelfs kleine onderbrekingen kostbaar kunnen zijn.
Redundantie is als het hebben van een reserveband voor je auto. Het is niet essentieel om te rijden, maar cruciaal als je een lekke band krijgt.
Wat is het verschil tussen redundantie en hoge beschikbaarheid?
Redundantie is een techniek die specifiek wordt gebruikt om hoge beschikbaarheid te bereiken. Beschouw redundantie als een instrument in de gereedschapskist. Het houdt in dat er een back-up is van een of meer apparatuuronderdelen om te zorgen voor een noodplan in het geval dat het eerste onderdeel uitvalt.
Hoge beschikbaarheid (HA) daarentegen is de algehele strategie om ervoor te zorgen dat uw systemen betrouwbaar operationeel zijn met een minimum aan onderbrekingen. Het omvat een breder scala aan strategieën, niet alleen redundantie, maar ook:
- Taakverdeling: Verdelen van ladingen over verschillende servers om te voorkomen dat een taak sommige van de servers overbelast.
- Regelmatig onderhoud: Problemen anticiperen en verhelpen voordat storingen optreden en de workflow in een bedrijfsorganisatie in gevaar brengen.
- Robuuste monitoring: Het snel identificeren van storingen en het uitvoeren van de noodzakelijke failover- of andere herstelprocessen.
Verder moeten systemen, om hoge beschikbaarheid in dynamische omgevingen te garanderen, het volgende integreren schaalbaarheid en elasticiteit om zich aan veranderende werklasten aan te passen.
Redundantie is daarom niet de enige factor voor hoge beschikbaarheid, maar wel een belangrijk onderdeel.
| Aspect | Redundantie | Hoge Beschikbaarheid |
|---|---|---|
| Kernomschrijving | ||
| Definitie | Een techniek om systeemback-up en noodvoorzieningen te garanderen | Uitgebreide strategie voor het behouden van systeembetrouwbaarheid |
| Hoofddoel | Zorg voor back-upsystemen om downtime te voorkomen | Zorg voor minimale systeemonderbreking |
| Operationele Aanpak | ||
| Belangrijkste Strategieën | Reserve-apparatuur en -systemen | Load balancing, onderhoud, monitoring, schaalbaarheid |
| Reikwijdte | Smal, gericht op back-upsystemen | Breed, omvattend meerdere systeembetrouwbaarheidstechnieken |
| Implementatie | ||
| complexiteit | Relatief eenvoudig back-upmechanisme | Complexere, veelzijdige aanpak |
| Relatie | Eén component van hoge beschikbaarheid | Omvat redundantie als strategie |
Wat zijn de drie soorten redundantie?
Drie veelvoorkomende typen redundantie zijn:
- Actief-actief: Beide redundante systemen delen gelijktijdig de werklast voor een maximale benutting van de bronnen.
- Actief-passief: Eén systeem is volledig operationeel (actief) en het andere systeem is dat niet (passief) en komt alleen in werking als het actieve systeem uitvalt.
- N+1-redundantie: U hebt het aantal systemen dat nodig is voor normale bewerkingen (N), plus nog een systeem voor back-updoeleinden.
Deze modellen kunnen op verschillende niveaus worden toegepast: stroomvoorziening (UPS-apparaten en generatoren), netwerkverbindingen van verschillende providers, opslag zoals RAID, en servers. Een redundant netwerk houdt een tweede pad stand-by voor het geval een verbinding uitvalt.
Heeft uw SaaS failover en redundantie nodig?
Of u failover en redundantie nodig hebt, hangt af van verschillende factoren. Overweeg de volgende vragen:
- Kan uw bedrijf enige downtime aan?
- Hoe essentieel zijn uw diensten voor uw klanten?
- Wat zijn de financiële gevolgen van serviceonderbrekingen?
Als downtime leidt tot omzetverlies of aantasting van het klantvertrouwen, of de uptime schendt die is beloofd in uw serviceovereenkomst, dan kunnen redundantie en failover kosteneffectieve oplossingen blijken te zijn.
Managed services kunnen failover uitvoeren voor delen van uw infrastructuur: op Amazon RDS bedragen de failover-tijden voor een Multi-AZ DB-instantie doorgaans 60-120 seconden (AWS). Test het voordat u het nodig heeft; met RDS kunt u een failover forceren door de instantie opnieuw op te starten.
Wat is het verschil tussen redundantie en noodherstel?
Redundantie en noodherstel (DR) dragen beide bij aan het operationeel houden van uw systemen, maar ze pakken verschillende scenario's aan:
Redundantie:
- Focus: Het minimaliseren van de kans op downtime in de eerste plaats.
- Hoe het werkt: Gebruikt reserveonderdelen of een extra vergelijkbaar systeem om over te nemen wanneer het hoofdsysteem niet meer werkt.
- Wanneer het wordt gebruikt: Voor kleine problemen zoals hardwarestoringen of stroomuitval op het niveau van een enkele node/faciliteit.
- Zie het als: Een reserveband voor uw auto als reserve voor het geval u een lekke band krijgt.
Rampenbestrijding:
- Focus: Het herstellen van systemen en gegevens na een grote onderbreking.
- Hoe het werkt: Omvat een uitgebreid plan voor het maken van back-ups van gegevens, het verplaatsen van bewerkingen naar een secundaire site en het online herstellen van systemen.
- Wanneer het wordt gebruikt: In het geval van grote gebeurtenissen zoals natuurrampen, cyberdreigingen of zelfs situaties waarin het hele systeem crasht.
- Zie het als: Net als zakelijke verzekeringspolissen wordt het gebruikt om herstel te vergemakkelijken in het geval van een ramp.
Kortom, redundantie wordt gebruikt om onverwachte downtime te voorkomen, en disaster recovery wordt gebruikt om systemen en gegevens te herstellen na een grote onderbreking. Redundantie verschilt van een back-up, omdat problemen zoals gegevensverwijdering of versleuteling kunnen worden gerepliceerd naar stand-by systemen, wat aangeeft dat afzonderlijke back-upstrategieën relevant zijn voor noodherstel.
Conclusie
Redundantie en failover zijn enkele van de meest vitale concepten die men kan gebruiken om de betrouwbaarheid en beschikbaarheid te bieden van kritieke systemen. Begrijp en implementeer deze concepten strategisch om onverwachte verstoringen op te vangen en de operationele activiteiten effectief te beheren.
Klaar om te beginnen?


 Nederlands
 English
 Español
 Português
 Português do Brasil
 Français
 Italiano
 Deutsch
 Polski
 Română
 Українська
 简体中文
 日本語
 한국어