
Skalierbarkeit und Elastizität
Was sind Failover und Redundanz in SaaS?
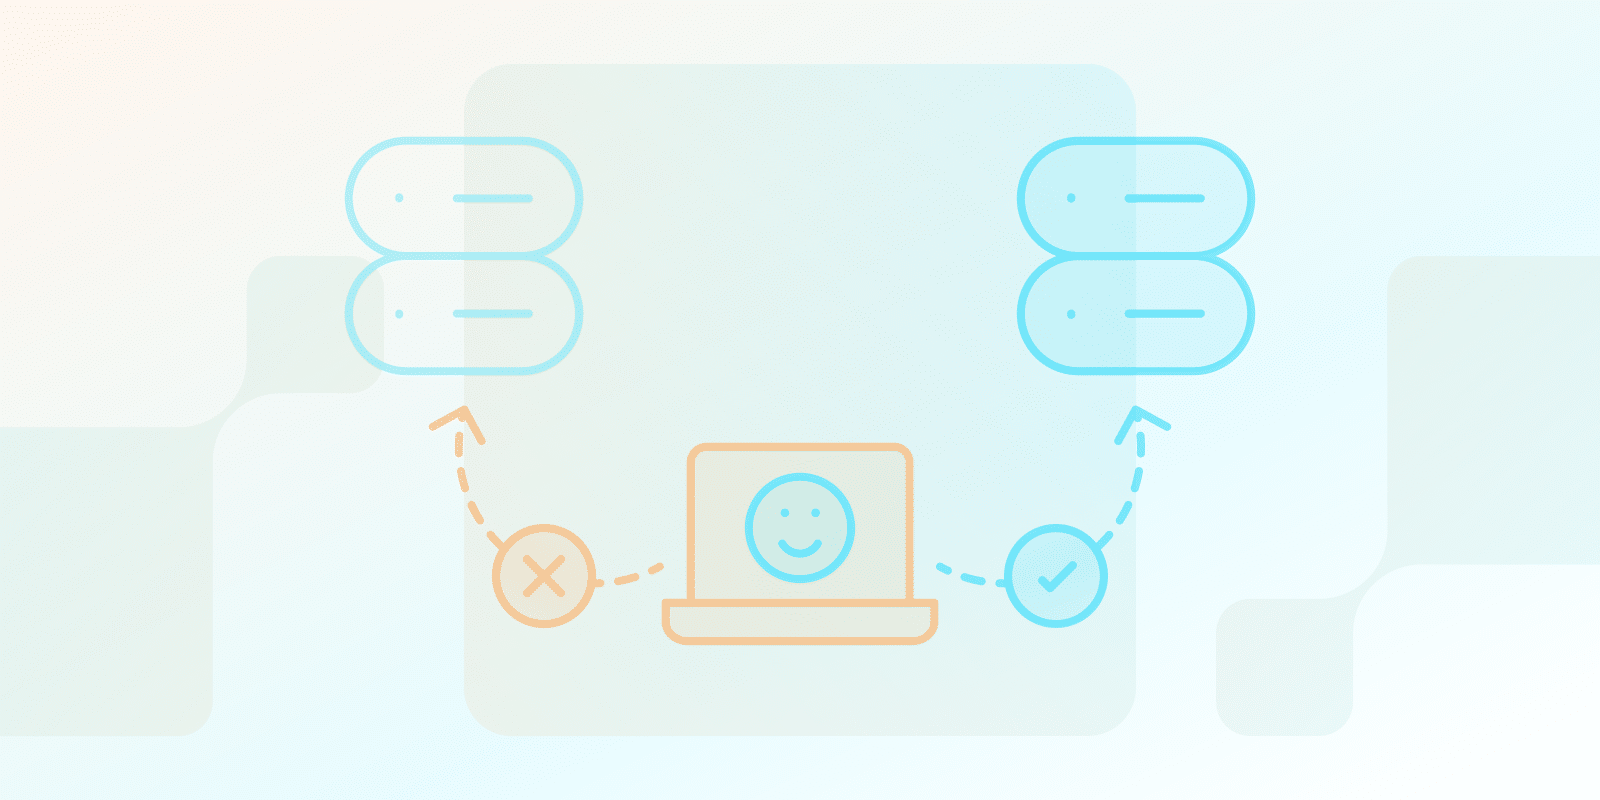
Was sind Failover und Redundanz?
Failover and redundancy are methods used to maintain the functionality of your systems, even during unexpected failures. Redundancy involves having backup parts or systems as substitutes, while failover is the switch, usually automatic, to those backups when the original system fails. Amazon RDS, for example, switches a Multi-AZ DB instance to its standby replica; failover times are typically 60–120 seconds.
On its own, failover solves smaller or localized issues, which are usually limited in scope, while disaster recovery (DR) is a solution for extensive issues such as natural disasters, cyber threats, or system crashes.
The presence of redundancy and failover configurations often relates to the level of disruption experienced during maintenance and upgrades, impacting service continuity. This is crucial in business, where even minor disruptions can be costly.
Redundanz ist wie ein Reservereifen für Ihr Auto. Er ist nicht unbedingt zum Fahren erforderlich, aber entscheidend, wenn Sie eine Reifenpanne haben.
Was ist der Unterschied zwischen Redundanz und Hochverfügbarkeit?
Redundanz ist eine Technik, die speziell zur Erreichung einer hohen Verfügbarkeit eingesetzt wird. Betrachten Sie Redundanz als ein Instrument im Werkzeugkasten. Es beinhaltet die Bereitstellung einer Sicherungskopie von einem oder mehreren Geräten, um im Falle eines Ausfalls des ursprünglichen Geräts für einen Notfall gerüstet zu sein.
High availability (HA), on the other hand, is the overall strategy of ensuring that your systems are reliably operational with a minimum of interruption. It includes a broader range of strategies, not just redundancy, but also:
- Lastverteilung: Aufteilen von Lasten auf verschiedene Server, um zu vermeiden, dass eine Aufgabe einige der Server überlastet.
- Regelmäßige Wartung: Antizipieren und Beheben von Problemen, bevor Ausfälle auftreten und den Arbeitsablauf in einer Unternehmensorganisation beeinträchtigen.
- Robuste Überwachung: Quickly identifying failures and executing the necessary failover or other recovery processes.
Um darüber hinaus eine hohe Verfügbarkeit in dynamischen Umgebungen zu gewährleisten, müssen Systeme Folgendes integrieren Skalierbarkeit und Elastizität um sich an wechselnde Arbeitslasten anzupassen.
Daher ist Redundanz nicht der einzige Faktor für hohe Verfügbarkeit, sondern eine wichtige Komponente.
| Aspekt | Redundanz | Hochverfügbarkeit |
|---|---|---|
| Kerndefinition | ||
| Definition | Eine Technik zur Sicherstellung von Systemsicherung und Notfallplanung | Umfassende Strategie zur Aufrechterhaltung der Systemzuverlässigkeit |
| Primäres Ziel | Bereitstellung von Backup-Systemen zur Vermeidung von Ausfallzeiten | Minimale Systemunterbrechung gewährleisten |
| Operativer Ansatz | ||
| Schlüsselstrategien | Backup-Ausrüstung und -Systeme | Lastenausgleich, Wartung, Überwachung, Skalierbarkeit |
| Umfang | Eng, fokussiert auf Backup-Systeme | Breit, umfassend mehrere Techniken zur Systemzuverlässigkeit |
| Implementierung | ||
| Komplexität | Relativ einfacher Backup-Mechanismus | Komplexerer, vielseitiger Ansatz |
| Beziehung | Ein Bestandteil der Hochverfügbarkeit | Redundanz als Strategie |
Welche drei Arten von Redundanz gibt es?
Three common types of redundancy sind:
- Aktiv-Aktiv: Beide redundanten Systeme teilen sich gleichzeitig die Arbeitslast für maximale Ressourcenauslastung.
- Aktiv-Passiv: Ein System ist voll funktionsfähig (aktiv), während das andere System nicht aktiv (passiv) ist und nur dann in Betrieb genommen wird, wenn das aktive System ausfällt.
- N+1-Redundanz: Sie verfügen über die Anzahl der für den Normalbetrieb erforderlichen Systeme (N) plus ein weiteres System für Sicherungszwecke.
These models can apply at several layers: power (UPS units and generators), network links from different providers, storage such as RAID, and servers. A redundant network keeps a second path ready if one link fails.
Benötigt Ihr SaaS Failover und Redundanz?
Die Entscheidung, ob Sie Failover und Redundanz benötigen, hängt von mehreren Faktoren ab. Berücksichtigen Sie die folgenden Fragen:
- Can your business handle any downtime?
- Wie wichtig sind Ihre Dienstleistungen für Ihre Kunden?
- Welche finanziellen Auswirkungen haben Dienstunterbrechungen?
If downtime translates into loss of sales or erosion of customer confidence, or breaks the uptime promised in your Service Level Agreement, then redundancy and failover may prove to be cost-effective solutions.
Managed services can run failover for parts of your infrastructure: on Amazon RDS, failover times for a Multi-AZ DB instance are typically 60–120 seconds (AWS). Test it before you need it; RDS lets you force a failover by rebooting the instance.
Was ist der Unterschied zwischen Redundanz und Notfallwiederherstellung?
Redundanz und Notfallwiederherstellung (DR) tragen beide dazu bei, Ihre Systeme betriebsbereit zu halten, aber sie bewältigen unterschiedliche Szenarien:
Redundanz:
- Fokus: Minimizing the chances of experiencing downtime in the first place.
- Funktionsweise: Verwendet Ersatzteile oder ein zusätzliches ähnliches System, um zu übernehmen, wenn das Hauptsystem nicht mehr funktioniert.
- When it’s used: Bei kleineren Problemen wie Hardwareausfällen oder Stromausfällen auf Einzelknoten- oder Einrichtungsebene.
- Stellen Sie sich das so vor: Ein Auto-Ersatzreifen, der als Reserve für den Fall einer Reifenpanne aufbewahrt wird.
Notfallwiederherstellung:
- Fokus: Restoring systems and data after a major disruption event.
- Funktionsweise: Umfasst einen umfassenden Plan zur Datensicherung, Verlagerung von Vorgängen an einen sekundären Standort und Wiederherstellung von Systemen online.
- When it’s used: Bei größeren Ereignissen wie Naturkatastrophen, Cyberbedrohungen oder sogar Situationen, in denen das gesamte System abstürzt.
- Stellen Sie sich das so vor: Ähnlich wie bei Unternehmensversicherungen wird es verwendet, um die Wiederherstellung im Katastrophenfall zu erleichtern.
In short, redundancy is used to prevent unexpected downtime, and disaster recovery is used to restore systems and data after a major disruption. Redundancy differs from a backup, as issues like data deletion or encryption may be replicated to standby systems, indicating that distinct backup strategies are relevant for Notfallwiederherstellung.
Schlussfolgerung
Redundancy and failover are some of the most vital concepts one can use to provide the reliability and availability of critical systems. Understand and strategically implement these concepts to address unexpected disruptions and manage operations effectively.
Bereit anzufangen?


 Deutsch
 English
 Español
 Português
 Português do Brasil
 Français
 Italiano
 Nederlands
 Polski
 Română
 Українська
 简体中文
 日本語
 한국어