
Escalabilidad y elasticidad
¿Qué son el failover y la redundancia en SaaS?
¿Qué son el failover y la redundancia?
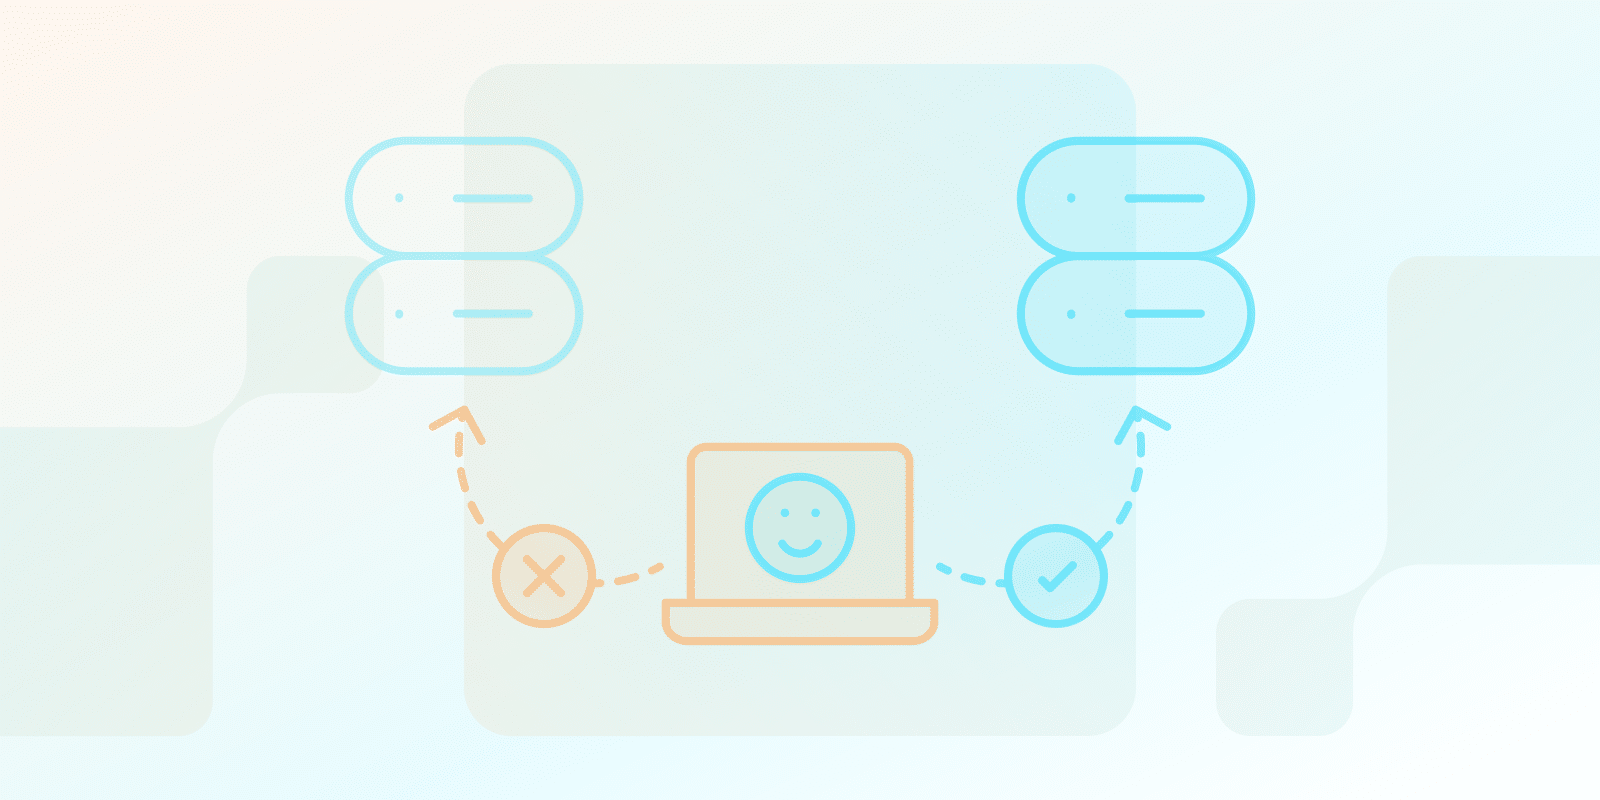
Failover and redundancy are methods used to maintain the functionality of your systems, even during unexpected failures. Redundancy involves having backup parts or systems as substitutes, while failover is the switch, usually automatic, to those backups when the original system fails. Amazon RDS, for example, switches a Multi-AZ DB instance to its standby replica; failover times are typically 60–120 seconds.
On its own, failover solves smaller or localized issues, which are usually limited in scope, while disaster recovery (DR) is a solution for extensive issues such as natural disasters, cyber threats, or system crashes.
The presence of redundancy and failover configurations often relates to the level of disruption experienced during maintenance and upgrades, impacting service continuity. This is crucial in business, where even minor disruptions can be costly.
La redundancia es como tener una llanta de repuesto para tu auto. No es esencial para conducir, pero es crucial si tienes un pinchazo.
¿Cuál es la diferencia entre redundancia y alta disponibilidad?
La redundancia es una técnica utilizada específicamente para lograr una alta disponibilidad. Considera la redundancia como un instrumento en la caja de herramientas. Implica tener una copia de seguridad de una o más piezas de equipo para garantizar la contingencia en caso de que la inicial falle.
High availability (HA), on the other hand, is the overall strategy of ensuring that your systems are reliably operational with a minimum of interruption. It includes a broader range of strategies, not just redundancy, but also:
- Balanceo de Carga: Dividir las cargas entre varios servidores para evitar que una tarea sobrecargue algunos de los servidores.
- Mantenimiento regular: Anticipación y rectificación de problemas antes de que ocurran fallas y comprometan el flujo de trabajo en una organización empresarial.
- Monitoreo robusto: Quickly identifying failures and executing the necessary failover or other recovery processes.
Además, para garantizar una alta disponibilidad en entornos dinámicos, los sistemas deben incorporar Escalabilidad y elasticidad para adaptarse a las cargas de trabajo cambiantes.
Por lo tanto, la redundancia no es el único factor de alta disponibilidad, sino un componente importante.
| Aspecto | Redundancia | Alta disponibilidad |
|---|---|---|
| Definición principal | ||
| Definición | Una técnica para garantizar la copia de seguridad y la contingencia del sistema | Estrategia integral para mantener la confiabilidad del sistema |
| Objetivo principal | Proporcionar sistemas de respaldo para evitar el tiempo de inactividad | Garantizar una interrupción mínima del sistema |
| Enfoque operativo | ||
| Estrategias clave | Equipos y sistemas de respaldo | Balanceo de carga, mantenimiento, monitoreo, escalabilidad |
| Alcance | Estrecho, enfocado en sistemas de respaldo | Amplio, abarcando múltiples técnicas de confiabilidad del sistema |
| Implementación | ||
| Complejidad | Mecanismo de respaldo relativamente simple | Enfoque más complejo y multifacético |
| Relación | Un componente de alta disponibilidad | Incluye la redundancia como estrategia |
¿Cuáles son los tres tipos de redundancia?
Three common types of redundancy son:
- Activo-Activo: Ambos sistemas redundantes comparten simultáneamente la carga de trabajo para una máxima utilización de recursos.
- Activo-Pasivo: Un sistema está completamente operativo (activo), y el otro sistema no lo está (pasivo) y solo entra en funcionamiento cuando el sistema activo falla.
- Redundancia N+1: Tiene el número de sistemas requeridos para operaciones normales (N), más un sistema más para fines de respaldo.
These models can apply at several layers: power (UPS units and generators), network links from different providers, storage such as RAID, and servers. A redundant network keeps a second path ready if one link fails.
¿Su SaaS necesita conmutación por error y redundancia?
Decidir si necesita conmutación por error y redundancia depende de varios factores. Considere las siguientes preguntas:
- Can your business handle any downtime?
- ¿Qué tan esenciales son sus servicios para sus clientes?
- ¿Cuáles son los impactos financieros de las interrupciones del servicio?
If downtime translates into loss of sales or erosion of customer confidence, or breaks the uptime promised in your acuerdo de nivel de servicio, then redundancy and failover may prove to be cost-effective solutions.
Managed services can run failover for parts of your infrastructure: on Amazon RDS, failover times for a Multi-AZ DB instance are typically 60–120 seconds (AWS). Test it before you need it; RDS lets you force a failover by rebooting the instance.
¿Cuál es la diferencia entre redundancia y recuperación ante desastres?
La redundancia y la recuperación ante desastres (DR) contribuyen a mantener sus sistemas operativos, pero abordan diferentes escenarios:
Redundancia:
- Enfoque: Minimizing the chances of experiencing downtime in the first place.
- Cómo funciona: Utiliza piezas de repuesto o un sistema similar adicional para hacerse cargo cuando el principal deja de funcionar.
- When it’s used: Para problemas menores como fallas de hardware o fallas de energía a nivel de nodo/instalación individual.
- Piensa en ello como: Una llanta de repuesto de automóvil guardada como respaldo en caso de que se pinche.
Recuperación ante desastres:
- Enfoque: Restoring systems and data after a major disruption event.
- Cómo funciona: Implica un plan integral para respaldar datos, trasladar operaciones a un sitio secundario y restaurar sistemas en línea.
- When it’s used: En casos de eventos importantes como desastres naturales, amenazas cibernéticas o incluso situaciones en las que todo el sistema se bloquea.
- Piensa en ello como: Similar a las pólizas de seguro comercial, se utiliza para facilitar la recuperación en caso de desastre.
In short, redundancy is used to prevent unexpected downtime, and disaster recovery is used to restore systems and data after a major disruption. Redundancy differs from a backup, as issues like data deletion or encryption may be replicated to standby systems, indicating that distinct backup strategies are relevant for recuperación ante desastres.
Conclusión
Redundancy and failover are some of the most vital concepts one can use to provide the reliability and availability of critical systems. Understand and strategically implement these concepts to address unexpected disruptions and manage operations effectively.
¿Listo para comenzar?


 Español
 English
 Português
 Português do Brasil
 Français
 Italiano
 Deutsch
 Nederlands
 Polski
 Română
 Українська
 简体中文
 日本語
 한국어